Amazon AlexaやGoogleアシスタントのような音声認識システム。一見ハードルが高そうに見えますが、Pythonを使えばわずかなコードでマイクから入力した音声をテキストに変換することができます。
最近はローカルで動かせる強力なAIモデルも増えていますが、「まずは環境構築の手間なく、サクッと無料で試したい」「シンプルなスクリプトで文字起こしを自動化したい」という用途では、GoogleのAPIを簡単に叩ける SpeechRecognition ライブラリが依然として非常に優秀です。
今回は、マイクから入力した音声をテキスト化する手順をステップバイステップで解説します。エラーが起きた際の解決策も合わせて記載しているので、ぜひ手元のローカル環境で検証しながら進めてみてください。
1. Pythonで音声認識を行うための前提準備
本記事のコードは、以下の環境で動作確認を行っています。手元のローカル環境でサクッと動かして検証したい場合に最適です。
- OS: Windows 11 / WSL2 (Ubuntu) など
- 言語: Python 3.x
- 主要ライブラリ:
SpeechRecognition(音声データをテキストに変換)PyAudio(マイクからの音声ストリームを取得)
ローカルで手軽に実行環境を構築し、実際の挙動を確認していきましょう。
2. ライブラリのインストールとエラー対策
入力音声をテキスト化するために、まずは必要なライブラリのインストールを行います。PowerShellやコマンドプロンプト(またはターミナル)を起動し、以下のコマンドを入力してください。
pip install SpeechRecognition pyaudio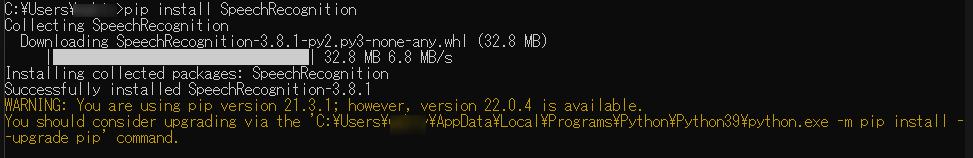
Successfully installed... と表示されれば基本のインストールは完了です。
Windows環境やWSL2でのPyAudioエラー解決法
Windows環境などで PyAudio をインストールしようとすると、C++のビルドツール関連のエラーでつまずくことがよくあります。その場合は以下の方法で回避できます。
▼ Windowsの場合 エラーが出る場合は、非公式のコンパイル済みバイナリ(.whlファイル)をダウンロードして直接指定してインストールするのが一番手っ取り早いです。
▼ WSL2 (Ubuntu) の場合 WSL2等のLinux環境を利用している場合は、OS側に依存パッケージが足りていないことが原因です。先に以下のコマンドで portaudio を入れておくことでエラーを解消できます。
sudo apt update
sudo apt install portaudio19-dev
pip install pyaudio
3. マイク音声を録音して文字起こしするPythonプログラム
「指定した秒数(今回は5秒間)だけPyAudioで録音し、WAVファイルとして保存した後に、SpeechRecognitionでテキスト化する」という、裏側の仕組みがしっかり理解できる実践的なコードです。
安全にリソースを解放できるよう、関数に分けて記述しています。以下のコードをコピペして実行してみてください。
import pyaudio
import wave
import speech_recognition as sr
import os

def record_audio(filepath, record_seconds=5):
    """PyAudioを使ってマイクから音声を録音し、WAVファイルとして保存する"""
    CHUNK = 4096
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 44100

    audio = pyaudio.PyAudio()

    try:
        # マイクのストリームを開く
        stream = audio.open(format=FORMAT,
                            rate=RATE,
                            channels=CHANNELS,
                            input_device_index=1, # ※環境に合わせてマイクのインデックスを変更してください
                            input=True,
                            frames_per_buffer=CHUNK)

        print(f"###### {record_seconds}秒間の録音を開始します。何か話してください! ######")
        frames = []

        # 指定秒数分データを読み込む
        for _ in range(0, int(RATE / CHUNK * record_seconds)):
            data = stream.read(CHUNK)
            frames.append(data)

        print("###### 録音終了 ######")

    finally:
        # リソースの解放(エラーが起きても確実に実行させる)
        stream.stop_stream()
        stream.close()
        audio.terminate()

    # 録音データをWAVファイルとして保存
    with wave.open(filepath, 'wb') as wave_f:
        wave_f.setnchannels(CHANNELS)
        wave_f.setsampwidth(audio.get_sample_size(FORMAT))
        wave_f.setframerate(RATE)
        wave_f.writeframes(b''.join(frames))

def recognize_audio(filepath):
    """保存したWAVファイルを読み込んでテキスト化する"""
    print("###### 音声認識を開始します ######")
    recognizer = sr.Recognizer()

    with sr.AudioFile(filepath) as source:
        audio = recognizer.record(source)
        try:
            # Google Web Speech APIを使って日本語として認識
            text = recognizer.recognize_google(audio, language='ja-JP')
            print("【認識結果】:", text)
        except sr.UnknownValueError:
            print("音声をうまく認識できませんでした。")
        except sr.RequestError as e:
            print(f"APIリクエストエラーが発生しました: {e}")

    print("###### 音声認識を完了しました ######")

if __name__ == '__main__':
    record_filepath = "rec.wav" # 一時保存するWAVファイルのパス

    # 1. 5秒間録音を実行
    record_audio(record_filepath, record_seconds=5)

    # 2. 録音したWAVファイルの音声認識
    recognize_audio(record_filepath)

    # 3. テスト後のクリーンアップ(検証が終わったらファイルを削除)
    if os.path.exists(record_filepath):
        os.remove(record_filepath)
4. サンプルコードの処理フロー解説
このプログラムでは、大きく分けて「録音」と「認識」の2つのステップを踏んでいます。
record_audio関数(録音処理)PyAudioを使ってマイクデバイスにアクセスし、5秒間の音声データを細切れ(CHUNK)に取得してリストに格納していきます。最後に標準のwaveライブラリを使って、ローカルにrec.wavというファイル名で書き出します。 ※try-finally文を使うことで、プログラムが途中で落ちても確実にマイクのデバイスリソースを解放するようにしています。recognize_audio関数(認識処理) 作成されたWAVファイルをSpeechRecognitionに渡し、recognize_googleメソッドでGoogleのサーバーに音声を送ってテキスト化(language='ja-JP'で日本語指定)しています。- クリーンアップ 無事にテキストが出力された後は、
os.removeでローカル環境に一時的に作成した音声データを破棄して綺麗に終了させます。
実際に手元でスクリプトを実行してマイクに向かって話しかけてみると、ターミナル上にしっかりとテキストとして出力される挙動が確認できるはずです。
5. まとめと応用
今回は SpeechRecognition と PyAudio を組み合わせて、マイク音声をWAVファイルに落とし込んでから文字起こしする実用的なコードをご紹介しました。
この処理をベースにすれば、「毎日の会議の音声を自動で録音して議事録のドラフトを作成する」「特定のキーワードに反応する音声アシスタントを作る」といったツールを自作することも十分に可能です。ローカル環境で実際にコードを動かして挙動を確かめながら、ご自身のアイデアに合わせてカスタマイズしてみてください。
また、今回は一時ファイル(WAV)を保存する形を取りましたが、「ファイルに保存せず、メモリ上でマルチスレッドを使ってリアルタイムにマイク音声を処理したい」という方は、以下の記事で詳しく解説していますので合わせて参考にしてみてください!
コメント